1. September 2007
TRW-Servolenkung: Wenn das Modell die Wahrheit ist — und der Kunde nur den Code sieht
Ein Kybernetiker hatte den Regelalgorithmus der Servolenkung als Simulink-Modell entworfen. Er musste als effizienter, seriennaher C-Code ins Steuergerät — doch der Kunde, ein erfahrener Embedded-C-Betrieb, sah nur den generierten Code und lehnte ihn als „minderwertig" ab.
Den modellbasiert generierten C-Code so aufbereiten, dass er effizient läuft, den Regelalgorithmus korrekt abbildet und für den Kunden als Artefakt akzeptabel — also lesbar — ist, ohne den modellbasierten Workflow zu zerstören.
Über TargetLink-/Simulink-Konfiguration wurde der Code lesbar und seriennah, wiederkehrende Subsysteme als Library gekapselt, die Funktion per SiL-Test mit CUnit abgesichert. Nach ~2–3 Monaten Kundenakzeptanz und Integration ins Steuergerät. Mein erster direkter Kundenkontakt.
Meine allererste Aufgabe im Berufsleben war ein Lehrstück — nicht nur technisch, sondern menschlich. Sie handelt von zwei Ingenieurs-Weltbildern, die frontal aufeinanderprallen, und von der Frage, die mich mit direktem Kundenkontakt ins kalte Wasser warf: Was ist eigentlich das „Produkt” — das Modell oder der Code?
Worum es geht: eine elektrohydraulische Servolenkung
Das komplette System heißt EPHS (Electro-Hydraulic Power Steering) — vom Lenkrad bis zum Pumpenmodul mit Steuergerät:
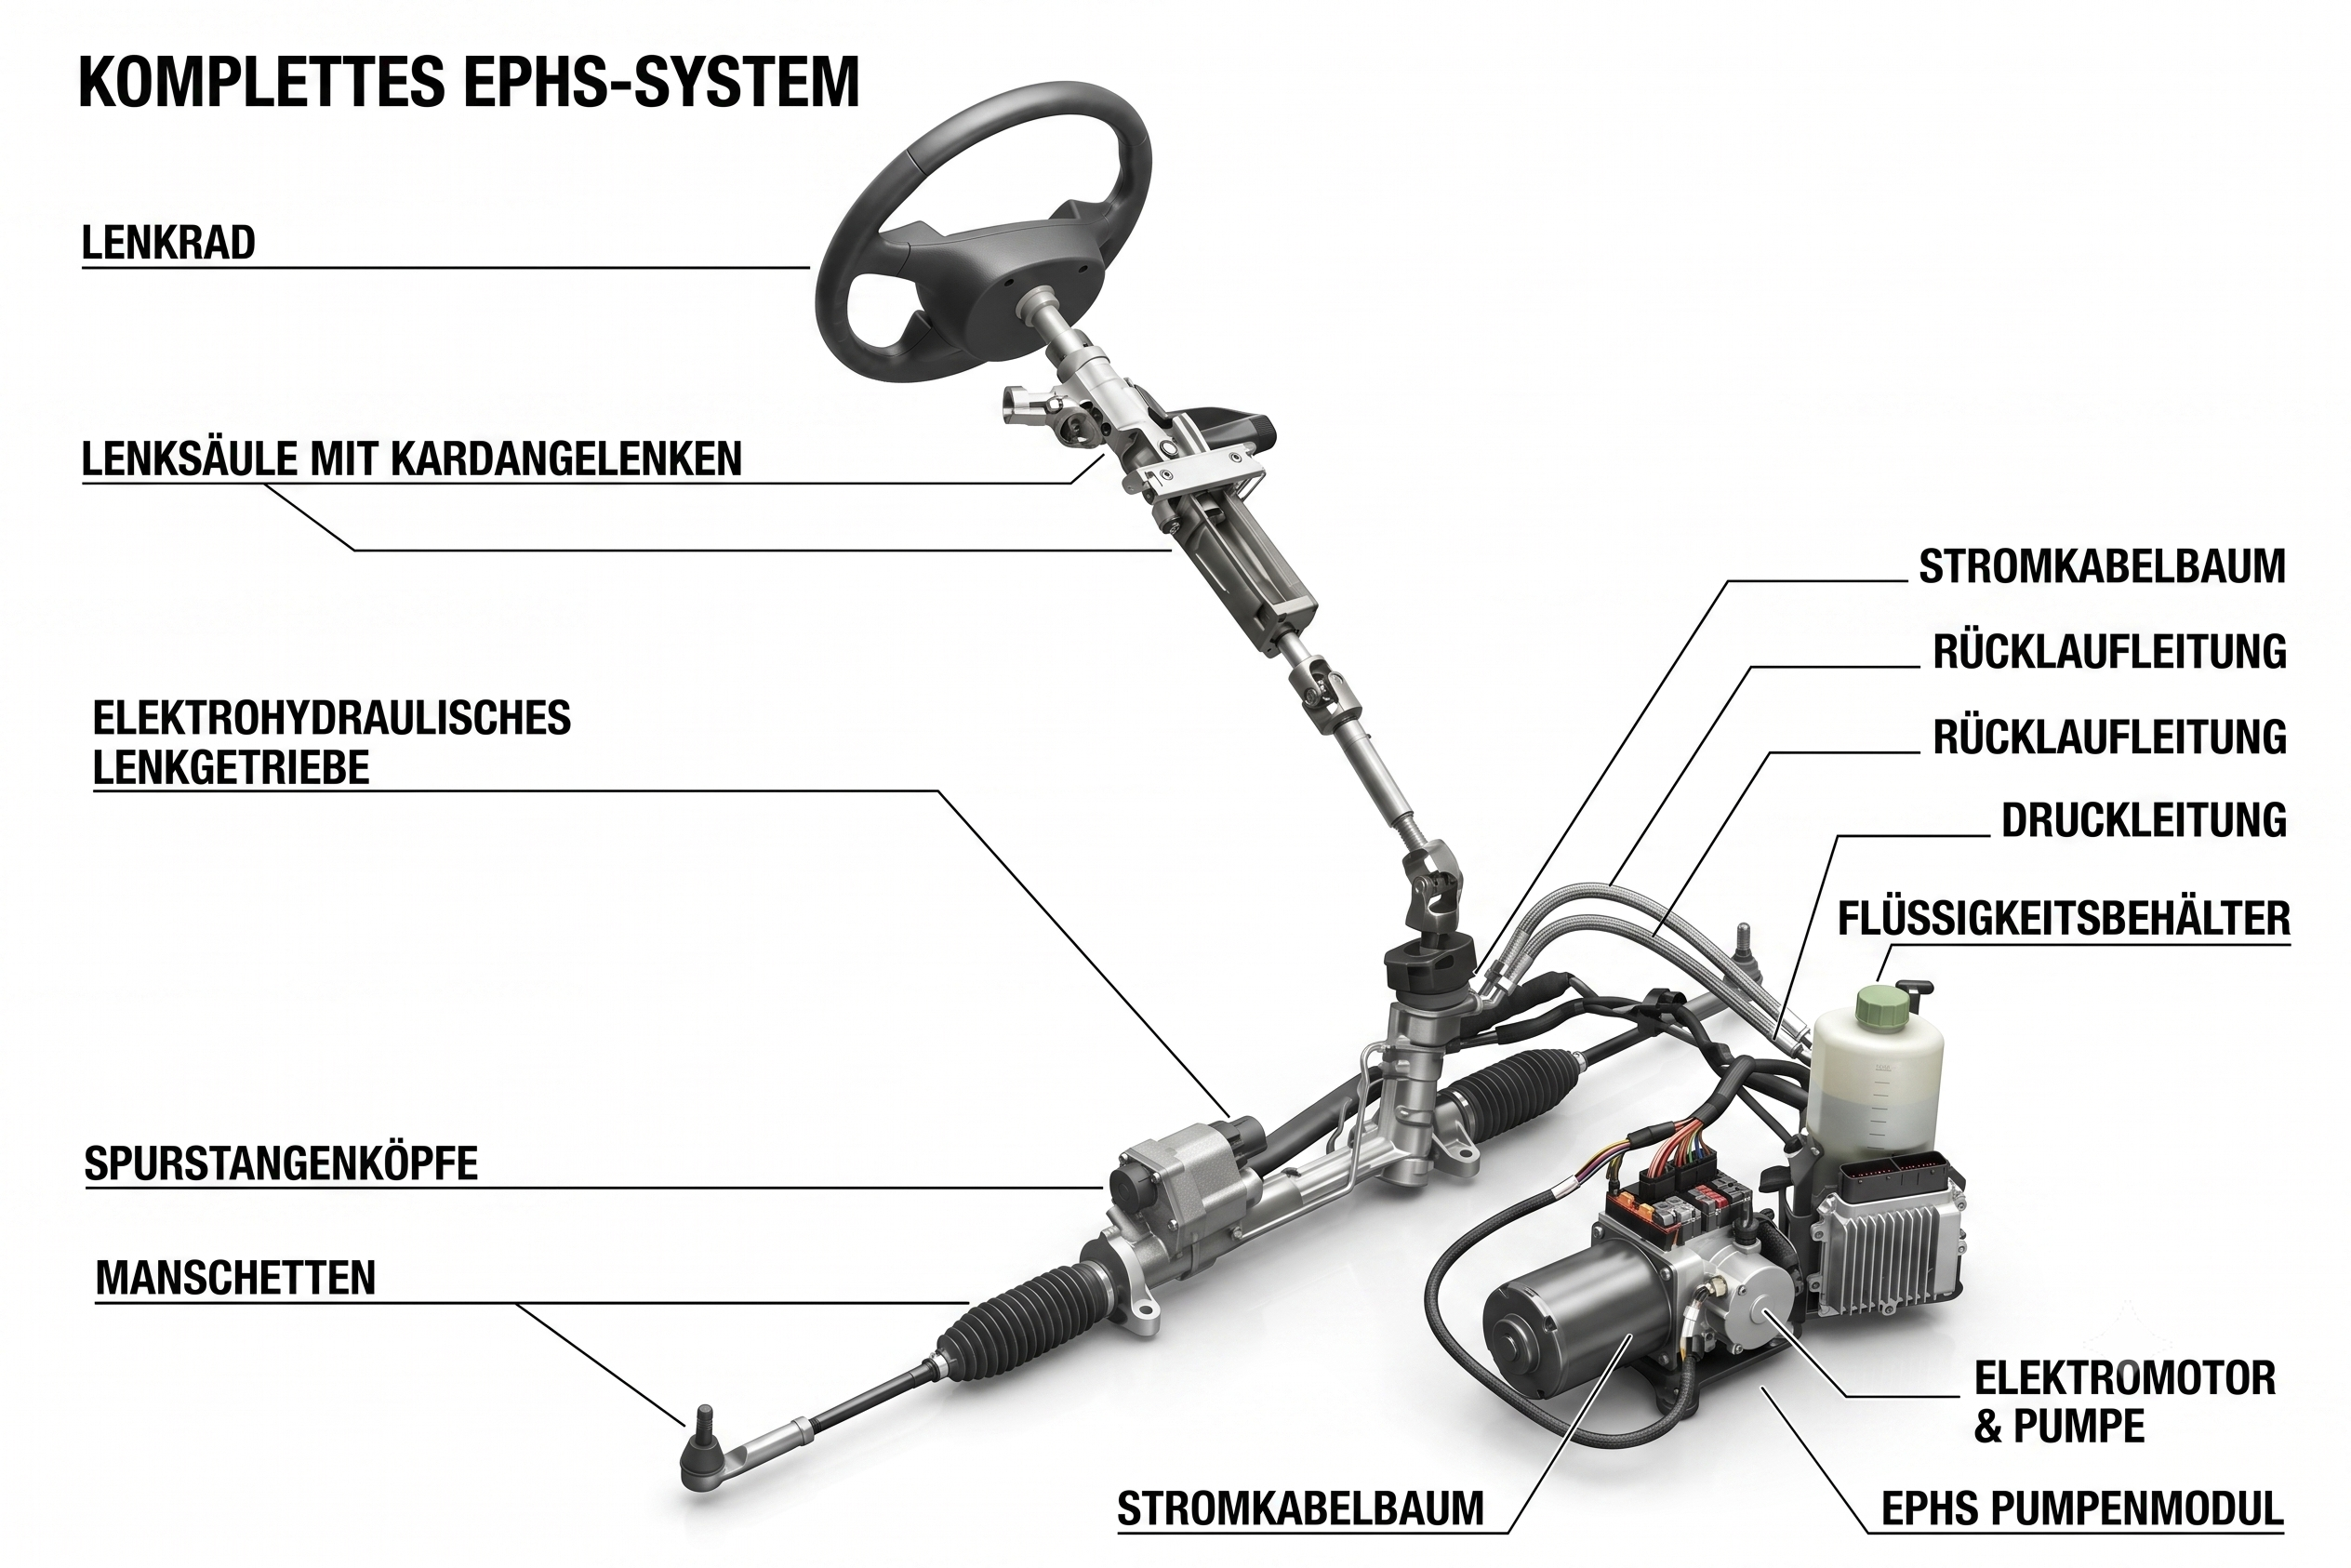
Eine Servolenkung nimmt dem Fahrer Kraft ab. Bei der elektrohydraulischen Variante erzeugt eine elektrisch angetriebene Pumpe den nötigen Öldruck — und ein Steuergerät entscheidet, wie viel Unterstützung gerade sinnvoll ist. Das ist erstaunlich subtil:
Diesen Regelalgorithmus hatte der Kybernetiker Dipl.-Ing. Fabian Kügler bei Gigatronik bereits als Simulink-Modell entworfen. Meine Aufgabe: dafür sorgen, dass daraus für das Steuergerät optimierter, seriennaher C-Code wird. Genau hier zahlte sich meine Diplomarbeit aus — ich hatte bereits Erfahrung mit der Autocode-Toolkette.
Warum ich? Ein Pilotprojekt trifft auf Embedded-Erfahrung
Modellbasierte Entwicklung war 2007 bei einigen OEMs schon Standard — für diese TRW-Niederlassung aber ein Pilotprojekt. Bis dahin wurden dort alle Funktionen von Hand in C übersetzt. Aus Projektlaufzeit-Gründen entschied sich TRW für Gigatronik, weil dort erfahrene modellbasierte Funktionsentwickler saßen. Die aber waren mit der Generierung von seriennahem C-Code relativ unerfahren — und genau da kamen meine Betriebssystem- und Diplomarbeitserfahrungen ins Spiel.
Ich baute meine erste Code-Version, testete sie in Software-in-the-Loop und setzte auf Basis der Signalspezifikationen (Fahrzeuggeschwindigkeit, Lenkwinkel …) eine Testumgebung in C mit dem Framework CUnit auf. Technisch: lief. Dann kam das erste Kundenmeeting.
Der Konflikt: „Das ist doch totaler Murks!”
Der Kunde war überhaupt nicht zufrieden. Sein Team war tief in C zu Hause — und es interessierte sich null für das eigentliche Artefakt, das Simulink-Modell mit seiner TargetLink-Konfiguration. Es schaute ausschließlich auf den generierten C-Code und bewertete ihn als minderwertig. Der Grund: Eine komplexe Anwendung — die Steuerung der elektrohydraulischen Pumpe — steckte in einer einzigen Funktion mit mehreren tausend Zeilen.
Das Spannende: Aus Sicht der modellbasierten Entwicklung war alles richtig. Aus Sicht eines erfahrenen Embedded-C-Entwicklers war es totaler Murks. Und ich, mit kaum Kundenerfahrung, stand mittendrin und war „schuld”.
Die Lösung: generierten Code lesbar machen — ohne den Workflow zu zerstören
Die Aufgabe, die ich nach Rücksprache mit den Funktionsentwicklern verstand: den Code lesbar machen. Aber ich durfte ihn nicht von Hand schreiben — das hätte den ganzen modellbasierten Workflow zerstört und das Modell stellenweise obsolet gemacht. Also musste ich tiefer: in die Subsystem-Struktur von Simulink und die Codegenerierungs-Optionen von TargetLink.
Schritt für Schritt brachte ich es so weit, dass ein Subsystem im generierten Code aussah wie eine von Menschen geschriebene C-Funktion — mit sinnvollen Namen und Grenzen. An manchen Stellen half das sogar dem Modell: Wiederkehrende Funktionsblöcke kapselte ich als Library, wodurch ich das Modell selbst aufräumte und Wiederverwendung schuf. Nach und nach, gemeinsam mit dem Kunden, wurde der Code für ihn akzeptabel — bis wir nach zwei bis drei Monaten endlich zum Testen kamen. Erst dann begann der Kunde, den Algorithmus ins Steuergerät zu integrieren und dort zu prüfen.
Absicherung: von MIL zu SiL
Die Absicherung lief auf zwei Ebenen des klassischen in-the-Loop-Vorgehens. Zuerst im Model-in-the-Loop (MIL): Das Simulink-Modell wurde mit realen Messdaten der Eingangsgrößen aus echten Fahrmanövern gespeist — echte Fahrten liefern echte Signalverläufe (Fahrzeuggeschwindigkeit, Lenkwinkel …).
Genau diese Messdaten habe ich anschließend, als Fixed-Point umgesetzt, für meine Software-in-the-Loop (SiL)-Umgebung wiederverwendet. So lief der generierte C-Code gegen dieselben realen Szenarien — nur eben auf Serien-Arithmetik — und ich prüfte ihn mit dem CUnit-Framework gegen die erwarteten Ausgänge:
Was ich daraus mitgenommen habe
Dieses erste Projekt hat mich technisch und menschlich geprägt:
- Zwei Welten übersetzen. Zwischen modellbasierter und klassischer C-Welt zu vermitteln, war die eigentliche Leistung — mehr als jede einzelne Zeile Code. Genau das begegnet mir bis heute: Wenn heute generierter oder KI-erzeugter Code auf erfahrene Entwickler trifft, ist es dieselbe Debatte.
- Fixed-Point & Auto-Scaling. Wie man ein float-getriebenes Modell in effiziente Festkomma-Arithmetik fürs Steuergerät überführt — und wie man die Codegenerierung so einstellt, dass auch für Menschen lesbare Artefakte entstehen.
- Testen statt hoffen. Der Software-in-the-Loop-Test mit CUnit gab die Sicherheit, dass der Regelalgorithmus nach jeder Modelländerung noch korrekt lief.
- Der Kunde hat immer einen Punkt — auch wenn die Methode „recht hat”. Der Code war nach Lehrbuch in Ordnung. Trotzdem hatte der Kunde ein echtes Bedürfnis (Vertrauen, Prüfbarkeit). Beides ernst zu nehmen, statt recht haben zu wollen, war meine wichtigste Lektion aus dem ersten Kundenkontakt.
Ein ziemlich großer Brocken für die allererste Aufgabe. Aber rückblickend genau die richtige — sie hat mir gezeigt, dass gute Softwarearbeit selten nur am Code hängt.
Danke
Der Regelalgorithmus, um den dieser Artikel kreist, stammt vom Dipl.-Ing. Fabian Kügler. Danke für die gute Zusammenarbeit und das saubere Modell — es war die Grundlage, auf der ich überhaupt aufsetzen konnte.